

前幾天我們主要都還是在 Google AI Studio 裡面調整 AI 助教的 Prompt 和功能,到了今天,就要正式把它搬到自己的程式裡。
今天進入系統串接,主要目標就是使用 Google 官方的 google-genai SDK,透過 Python 實際呼叫 Gemini API。不過在開始寫 API 之前,我們先釐清一個很值得弄清楚的問題:
為什麼專案裡會有 test_gemini.py、test-chat.js、test-tutor.js 這麼多測試檔?為什麼不直接全部寫進 server.js?
其實這跟實際開發時的除錯方式很有關係。如果今天網頁突然沒有回應,直接把所有東西都塞在 server.js 裡,我們很難馬上知道問題到底出在哪裡。
所以今天先把不同功能拆開,一層一層確認,最後再整合回正式系統。
在打造「AI 虛擬助教系統」的過程中,如果我們跳過測試直接在正式伺服器(server.js)撰寫所有邏輯,一旦網頁沒有回應,我們將無法判斷是 API Key 無效、Prompt 邏輯錯誤,還是前端 fetch() 連線失敗。
因此,我們採用了由漸進式驗證(Progressive Verification)的策略:
各檔案的串接位置與核心用意如下:
test_gemini.py|先確認 API 能不能正常連線這是最基本的測試。
它的工作就是確認:
google-genai 有沒有安裝成功所以這裡不需要放一大堆教學 Prompt,只要丟一個很簡單的問題。
只要這一步成功,就代表最底層的 API 基礎建設okk沒問題。
test-chat.js|確認 AI 能不能記住前面的對話確認 API 可以正常使用之後,下一步就是測試 Chat Session。
例如:
我:「我叫小明。」
AI:「你好,小明!」
我:「那你知道我的名字嗎?」
這時候我們就可以確認 Gemini 有沒有保留前面的對話內容,之後學生在學習時才不會鬼打牆,
這個檔案主要測的是多輪對話與上下文記憶,所以先不管網頁介面長什麼樣子,可以直接在 Terminal 裡測試就好。
test-tutor.js|確認 AI 有沒有真的照我們設定的方式教學前面幾天我們已經在 AI Studio 裡面調整過「蘇格拉底式 AI 助教」的 Prompt,所以這裡要確認一件事情:把 Prompt 搬進程式之後,AI 還會不會照原本的規則教學生?
例如學生答錯時,AI 應該要透過提問和提示,引導學生自己思考,而不是直接把答案丟出來。
所以這個測試檔主要是在確認「教學邏輯」有沒有正常運作。
server.js|最後才是正式對外提供服務前面幾個測試都確認沒問題之後,才會把這些功能整合到正式後端 server.js。
server.js 會負責開啟 HTTP Server,例如:
Port 3000
然後建立 API Endpoint,讓前端網頁可以透過 fetch() 把學生的問題送到後端。
test_gemini.py 實作步驟架構搞懂之後,就可以正式開始寫第一個 API。
首先安裝 Google 官方的 google-genai:
pip install google-genai
接著設定 API Key。這裡有一個很重要的觀念:不要直接把 API Key 寫死在 Python 程式裡。
不要寫成:
client = genai.Client(api_key="AIzaSy...")
因為之後如果把程式碼放到 GitHub,很容易不小心把自己的 API Key 一起公開,token都燒給別人用。
所以我們改用環境變數:
export GEMINI_API_KEY="AIzaSyYourActualKeyHere..."
Python 就可以直接透過:
client = genai.Client()
讀取這個環境變數。
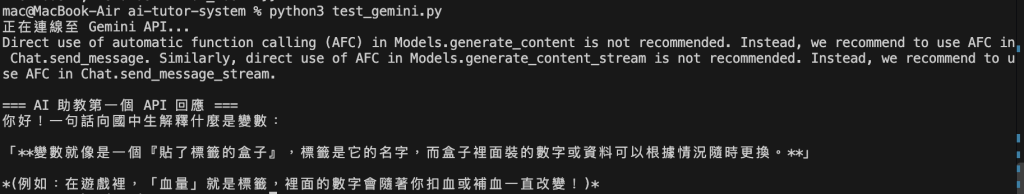
test_gemini.py今天的第一個目標其實很簡單:
先成功叫 Gemini 回一句話。
我也順便加入了一個簡單的 Retry 機制。
因為 API 並不是每一次都一定會成功,有時候可能會遇到 503 Service Unavailable,代表目前服務暫時無法處理請求,這種情況如果直接讓程式中斷,其實有點可惜,所以我們可以設計讓程式等兩秒,再重新嘗試。
以下為今天實作的 test_gemini.py 完整 Python 程式碼,包含了連線診斷與重試機制:
Python
import os
import time
from google import genai
from google.genai.errors import APIError

print("正在連線至 Gemini API 進行基建測試...")

# 1. 初始化 Client(自動讀取環境變數 GEMINI_API_KEY)
client = genai.Client()

# 2. 指定模型
model_name = "gemini-3.6-flash"

# 3. 設定容錯與重試機制
max_retries = 3
for attempt in range(max_retries):
    try:
        response = client.models.generate_content(
            model=model_name,
            contents="你好!請用一條白話文向國中生解釋什麼是『變數』?",
        )
        print("\n=== AI 助教第一個 API 回應 ===")
        print(response.text)
        break  # 成功取得回應,跳出迴圈
    except APIError as e:
        if e.code == 503 and attempt < max_retries - 1:
            print(f"⚠️ 伺服器繁忙 (503),等待 2 秒後進行第 {attempt + 2} 次重試...")
            time.sleep(2)
        else:
            print(f"\n[連線診斷錯誤]:{e}")
            break
這段程式其實可以拆成幾個很容易理解的部分。
genai.Client()先建立 Gemini 的 Client。
可以把它想成:
「我要準備一個可以跟 Gemini 溝通的工具。」
generate_content()接著呼叫:
client.models.generate_content()
這就是實際把問題送給 Gemini。
其中:
model=model_name
指定要使用哪一個模型,而:
contents="..."
就是我們想問 AI 的內容。
try / except這部分則是在處理 API 發生錯誤的情況。
如果 Gemini 正常回覆,就印出結果。如果遇到 API Error,就進入 except。
而我們特別檢查:
e.code == 503
如果是 503,就等待兩秒再試一次,最後成功看到 Gemini 回傳內容,就代表今天最基本的 API 串接完成了。
今天表面上看起來只是「成功呼叫一次 Gemini API」,但其實更重要的是開始理解一個完整 AI 系統為什麼要分層測試。這樣做的好處就是:哪一層壞掉,我們比較容易找到問題。
如果今天 test_gemini.py 就跑不動,那就不用浪費時間去檢查前端。
如果 API 可以正常使用,但是 test-tutor.js 的教學方式怪怪的,那問題就比較可能出在 Prompt 或教學邏輯,這就是為什麼實際開發時,不一定會把所有程式全部塞進同一個檔案。
今天做完之後,我覺得這種「先拆開測試,再慢慢整合」的方式,放到教育系統裡其實也很重要。
假設未來真的有一間學校,同時讓幾十個甚至幾百個學生使用 AI 助教, 這時候如果系統突然沒有回應,最怕的就是大家只能看到一個「AI 壞掉了」,卻不知道到底是哪一層出了問題,所以對 AI 教育系統來說穩定性其實也是學習體驗的一部分。
另外,將 API 串接、對話記憶、教學邏輯拆開,也讓之後修改系統變得比較容易。假設未來想修改蘇格拉底式教學 Prompt,就不需要連 API 基礎設定或前端程式一起改。
今天先完成了第一步:**讓 Python 成功跟 Gemini 溝通。**明天 Day 08 就要繼續往上加功能,來實作 Gemini 的 Chat Session 與歷史對話管理。
也就是從今天的:「問一次 → 回一次」
進一步變成:「問了好幾次 → AI 還記得前面發生什麼事。」
這會是後面做「學生盲點追蹤」很重要的一步。


 iThome鐵人賽
 看影片追技術